Gated DeltaNet 的状态(State)到底用了多少?把剩下的部分丢掉,又会发生什么?
Qwen3.5-0.8B 的每个线性注意力 head 都维护一个 128×128 的矩阵作为 memory。跑完 16K token 后,大多数 head 的 numerical rank 都是 127,几乎已经满秩。
但 numerical rank 在这里并不能很好地反映 state 实际用了多少容量。换成 effective rank 之后,结果要小得多:整个模型没有一个 head 超过约 44,中位数只有 8,还有相当一部分 head 连 3 个方向都不到。
这篇文章主要想回答三个问题:
- 一个看起来接近满秩的 state,实际有多少个有效方向?
- 是什么决定了这些方向的数量?
- 以及那些能量很小的方向到底有没有用?
先给结论:在 perplexity 上,把这些低能量方向去掉几乎没有影响;到了 retrieval 和 tracking 任务上,情况就不一样了;而且在某些任务里,去掉一部分低能量方向,性能反而会更好。
下面的实验都在未经修改的 Qwen3.5-0.8B backbone 上完成:18 层 Gated DeltaNet、6 层 full attention,每个线性注意力层有 16 个 head,每个 head 的状态都是 128×128。少数实验使用了一个架构相同的蒸馏 control checkpoint。
1. 怎么测出真实的“秩”
Numerical rank 统计的是高于 float32 数值精度阈值的奇异值。
但对于带 decay 的 recurrent state,这个指标很容易高估真正有效的维度。
假设某个方向在 15K token 之前被写入状态。之后每经过一个 token,它都会乘一次衰减因子 $\alpha$。即使已经这样衰减了几千次,只要最后仍然高于
$$ \sigma_{\max} \cdot 128 \cdot \varepsilon $$
numerical rank 就会继续把它算作一个有效方向。
因此,几乎所有 head 最后都会得到 126、127 这样的 rank。
问题在于,这只能说明这些方向还没有小到被浮点数精度直接抹掉,并不能说明它们在 state 中仍然占有多少分量。
这里更有意义的是 effective rank。设奇异值为 $\sigma_i$,并令
$$ p_i = \frac{\sigma_i}{\sum_j \sigma_j} $$
则 effective rank 定义为
$$ \operatorname{erank} = \exp\left(-\sum_i p_i \log p_i\right) $$
它衡量的是 state 的能量分布在多少个方向上。
如果 128 个奇异值完全相同,effective rank 就是 128;如果几乎所有能量都集中在一个方向上,effective rank 就接近 1。
我让模型读完一个 16,384-token 的文档,然后对每个 head 的 carried state 计算 effective rank。下面的结果取 8 个文档上的中位数。
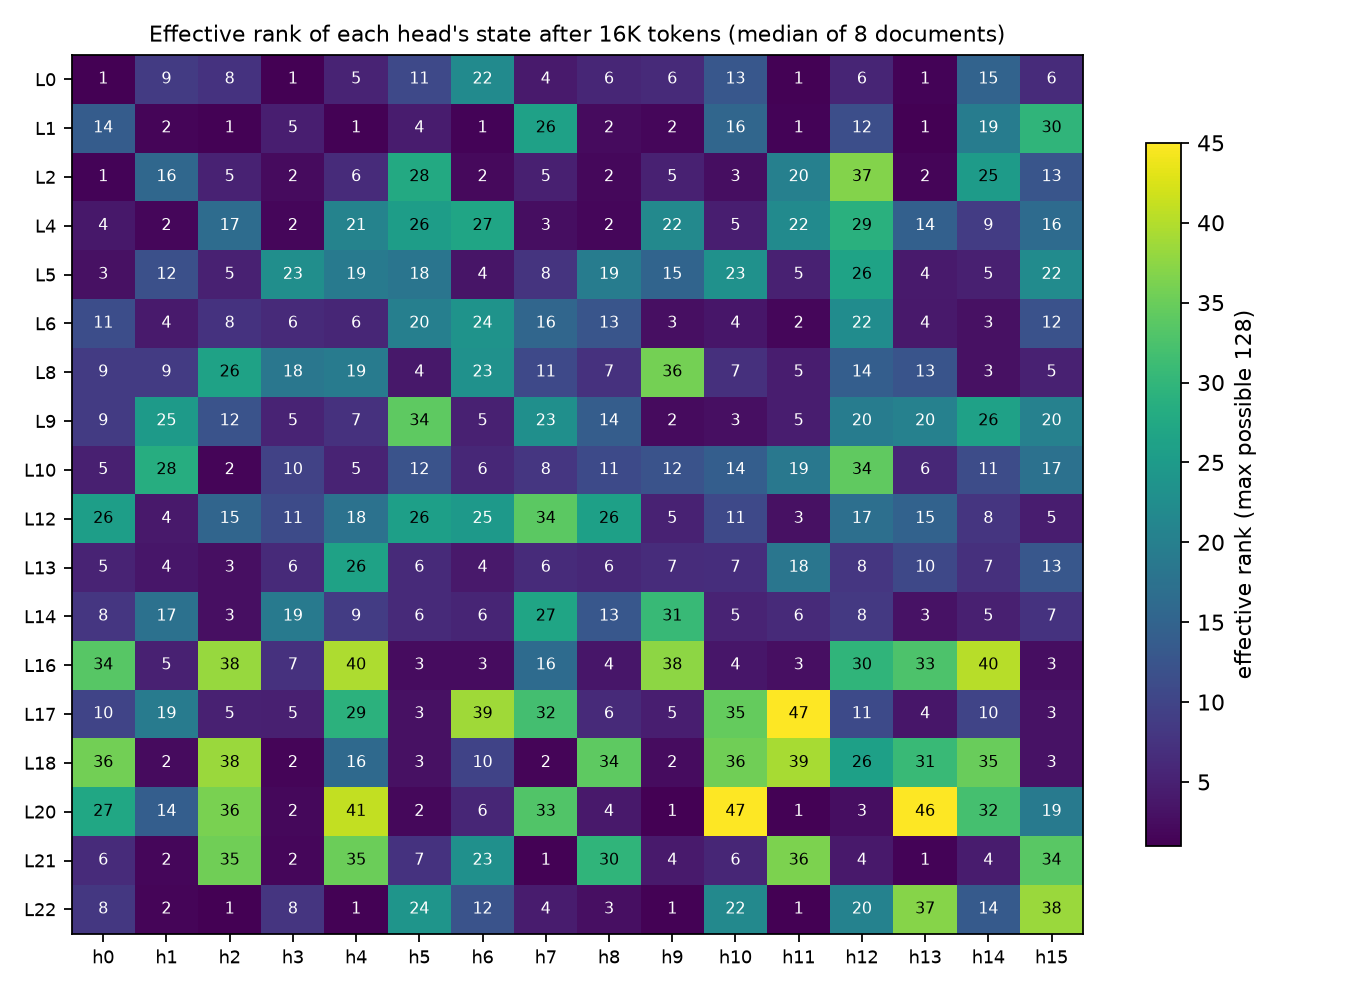
图 1:各层、各 head 的 effective rank。
| 288 个 head 的统计结果 | 数值 |
|---|---|
| 最大 effective rank | 43.5 |
| 中位数 | 8.2 |
| effective rank ≤ 3 | 19% |
| effective rank < 10 | 53% |
| effective rank > 25 | 19% |
不同文档之间的差别很小。对绝大多数 head 来说,8 个文档上的 min–max range 都比较窄。
也就是说,effective rank 更像是 head 本身的一个稳定属性,而不是由某篇输入文本偶然决定的。
再看 numerical rank = 127 的那些 head,effective rank 最高也只有 30–44。第 0 层甚至有一些 numerical rank 同样是 127 的 head,effective rank 只有 5–8。
所以 numerical rank 里统计进去的很多方向,其实已经非常弱,只是还没有小到低于浮点数精度阈值。
2. 为什么只有这么几个方向?
最直接的解释是 decay horizon。
如果一个 head 的逐 token 衰减因子是 $\alpha$,那么它的记忆长度大约是
$$ \frac{1}{1 - \alpha} $$
另一方面,在 delta rule 里,对相同 key 的重复写入会逐渐收敛,而不是像简单累加那样不断增加新的方向。
因此,一个自然的猜测是:state 里最终能保留多少个方向,主要取决于 horizon 内出现了多少个不同的 key。
这个解释和实验结果基本一致。
在所有 head 上,effective rank 和 horizon 的 Spearman correlation 是 0.91。
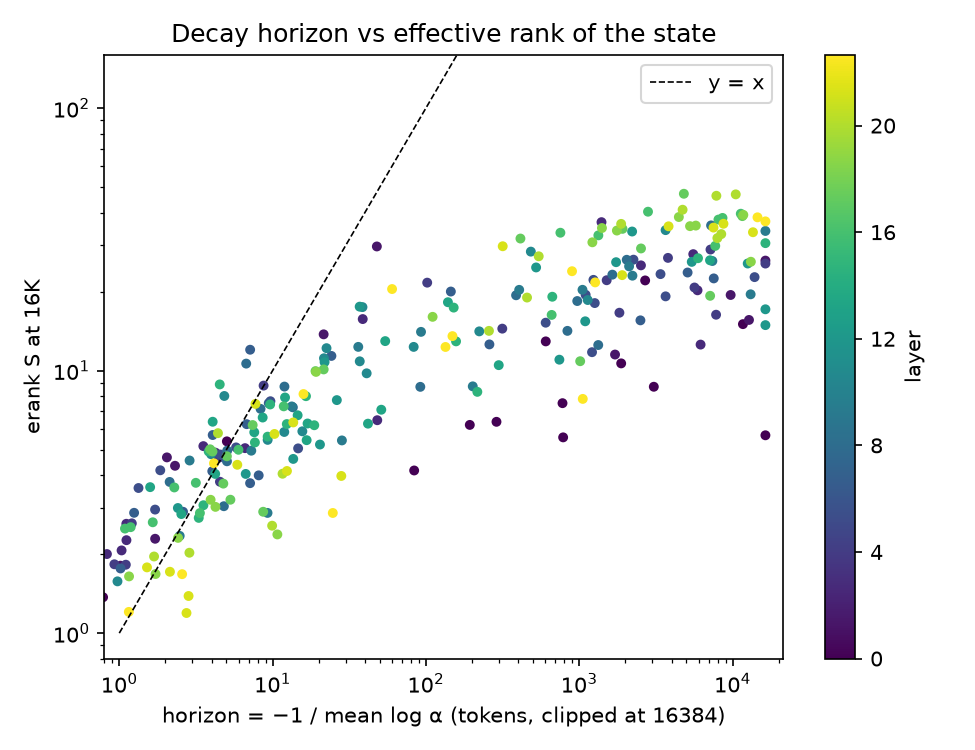
图 2:horizon $= -1 / \operatorname{mean}(\log \alpha)$ 与 effective rank 的关系。横轴使用 log scale,每个点对应一个 head,$y=x$ 作为参考。
不过,数据并不会一直沿着 $y=x$ 增长。
horizon 小于 10 的 head 基本贴着对角线;但当 horizon 增加到 5,000–10,000 token 后,effective rank 仍然停在 30–47 左右。
也就是说,horizon 足够长以后,继续减慢 decay 并不会让 state 的 rank 一直增加。
接下来限制 rank 的是 key 本身。
在这些 long-horizon head 里,L2-normalized key 都集中在一个很窄的 cone 中。平均 key 的范数达到 0.8–0.94,而 horizon 内写入的 key,其普通 covariance 的 effective rank 只有 3–6。
说明这些 key 之间高度相关。
那为什么 state 的 effective rank 最后还能到 40 左右?
原因在 delta rule。对于相似的 key,delta update 会逐渐消去它们共有的部分,剩下较小的 residual,再由这些 residual 慢慢积累出新的方向。
因此,state 的 rank 可以明显高于原始 key covariance 的 rank。
不过最终的上限仍然取决于 key 本身能提供多少独立方向。对这些 long-horizon head 来说,真正限制 effective rank 的不是 decay,而是 key diversity。
从这里还能看到两个现象。
首先,61% 的 head 会在 256 token 内忘掉大部分之前的信息。对这些 head 来说,不管 state matrix 有多大,它们主要还是在做短程 mixing。
其次,那些 long-horizon head 其实也远没有把 128 个方向用满。它们的 decay 足够慢,可以保留几千个 token 之前的内容,但受 key geometry 限制,最后有效的方向仍然只有几十个。
还有一点容易让人困惑。
这些 long-horizon head 的 decayed key covariance $P$,effective rank 往往只有 2–6,而 state 本身却能达到 35–47。
这两者并不矛盾。
Covariance 的 eigenvalue 对应 amplitude 的平方,而 state 这里用的是 singular value。把两者换到相同尺度之后,结果其实是一致的。
3. 这些低能量方向到底有没有用?
Effective rank 只能告诉我们 state 的能量主要分布在哪些方向上。
但能量小,并不代表模型一定不会用。
所以最直接的办法,就是把这些方向删掉,再看模型的输出会怎么变化。
怎么删
我把模型按 256-token segment 运行。
每到一个 segment 边界,就取出所有 head 的 carried state,对每个 state 计算最大的 $r$ 个 left singular directions,然后把 state 投影到这 $r$ 个方向组成的子空间里。
接下来一个 segment 读到的是截断后的 state,新内容也继续写回这个 state。
因此,这个操作不是只做一次。每经过一个 segment,state 都会再次被截断,影响会沿着后续序列不断累积。
换句话说,超过一个 segment 的旧 memory 最多只能保留 $r$ 个方向;当前 256-token segment 内新产生的状态则不受限制。
$r = 128$ 就对应原始模型。
这个操作同时应用到所有 linear layer 的所有 head,6 个 full-attention layer 完全不动。
Perplexity:这些方向几乎是死的
还是前面的 8 个文档。下面是保留不同 $r$ 时的 mean next-token loss,以及它相对原模型的变化。
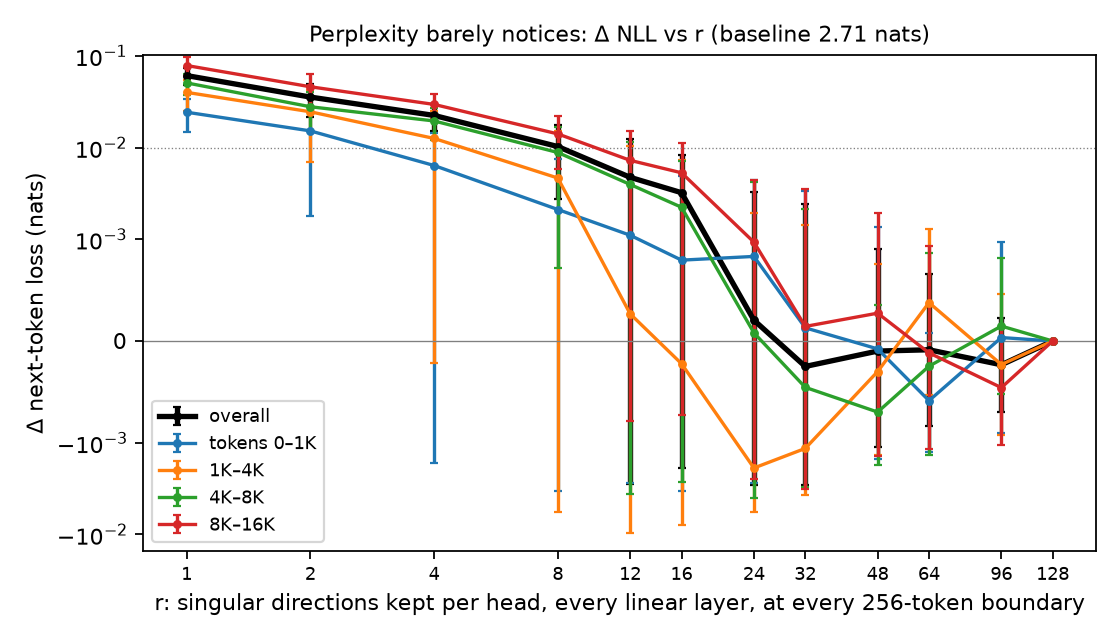
图 3:不同 $r$ 下的 Δ NLL,包括整体结果和不同 position bucket。
| 每个 head 保留的 r | Δ NLL(nats) |
|---|---|
| 48 | −0.0001 ± 0.0010 |
| 24 | +0.0002 ± 0.0031 |
| 12 | +0.0047 |
| 4 | +0.0224 |
| 1 | +0.0611 |
结果很明显。
保留 48 或 24 个方向时,和原模型几乎没有区别。
即使每个 head 只保留 12 个方向,loss 也只增加约 0.5%;压到 1 个方向,loss 也只增加约 2%。
我还单独看了典型的 copy / induction token:它们前面的 bigram 曾经在 512 token 以前出现过。
这些 token 对 truncation 的敏感程度和普通 token 并没有明显区别。
至少在 web text 上,即使把整个 recurrent stack 的长程 state 压到很低的 rank,对 next-token prediction 的影响也只有大约 0.06 nats。
这里的 long-range copying 主要还是由 full attention 完成。
Retrieval:完全是另一回事
把同样的 truncation 用到 RULER 上,结果就不一样了。
下面的分数是 RULER 的 string match,每项使用 50–200 个样本。aggregation task 使用蒸馏后的 control checkpoint,因为 base model 在这些 prompt 上比较不稳定。
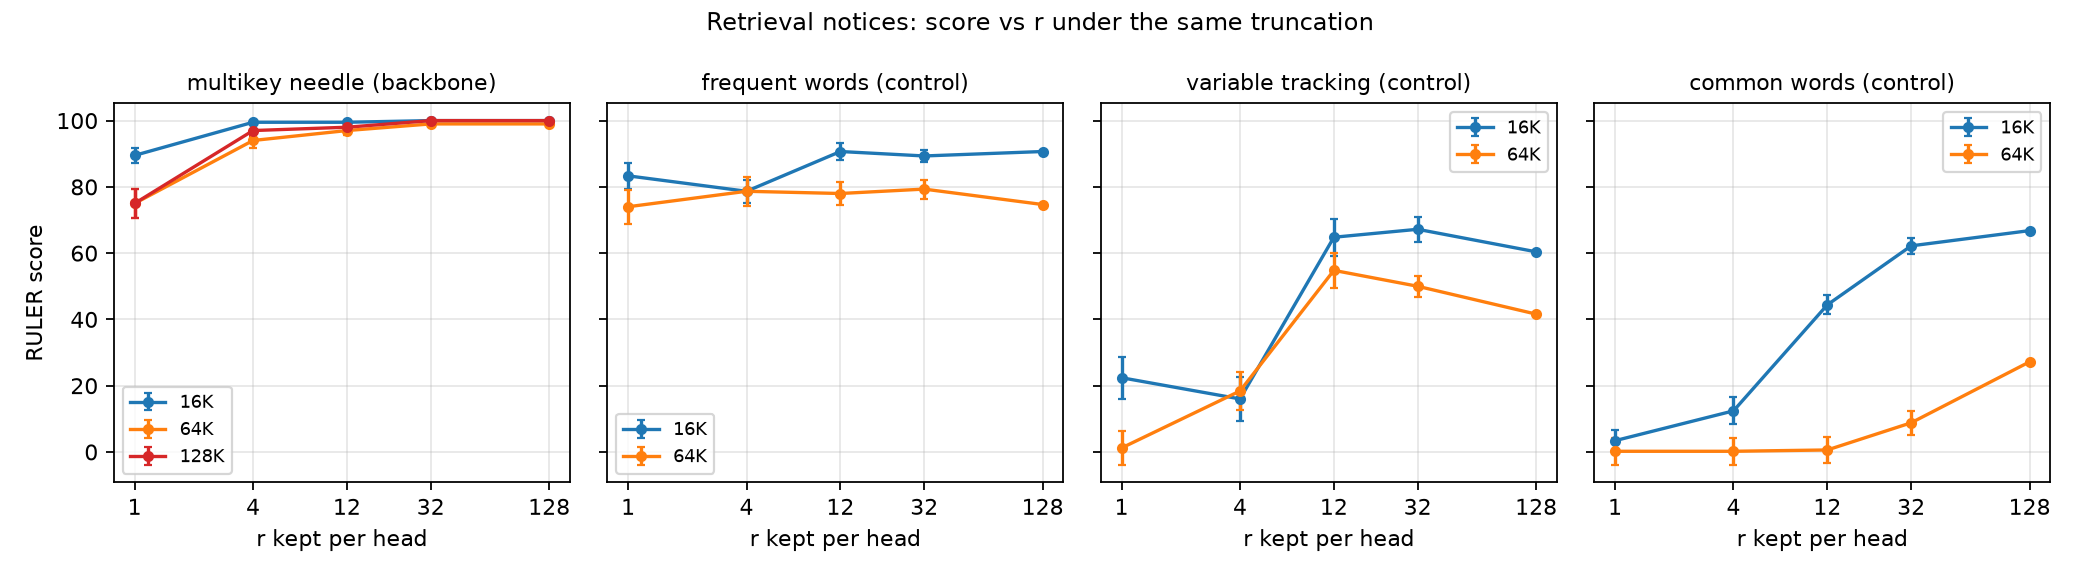
图 4:needle retrieval 以及 cwe、fwe、vt 随 $r$ 的变化。
| 每个 head 保留的 r | multikey needle, 64K | frequent words, 64K | variable tracking, 16K | common words, 16K |
|---|---|---|---|---|
| 128 | 99 | 75 | 60 | 67 |
| 32 | 99 | 79 | 67 | 62 |
| 12 | 97 | 78 | 65 | 44 |
| 4 | 94 | 79 | 16 | 12 |
| 1 | 75 | 74 | 22 | 3 |
当 $r = 1$ 时,perplexity 只差了 2%,但 64K、128K 的 needle retrieval 已经少了大约四分之一,variable tracking 也接近失效。
这说明 web-text perplexity 对 long-range state 的变化并不敏感。
原因也很直接:普通网页文本里的 next-token prediction,很少要求模型准确读取几千 token 以前的某一条特定信息。
不同任务需要的 rank 也不一样。
Single-needle retrieval 大约保留 4 个方向就够了。
在 64K token 中找出现频率最高的三个词,保留 1 个方向基本也能完成。这个结果并不奇怪,因为对 value 做 exponential moving average,本身就可以承担一部分这类统计。
Variable tracking 需要的维度更高,大约要保留 12 个方向;降到 4 个之后,性能就会明显下降。
真正开始受到 state capacity 限制的是 common words:从 16K 的列表里找出出现次数最多的 10 个词。
$r = 12$ 时会掉 22 分,$r = 32$ 时仍然会掉 5 分。
到了 64K,这个任务本身的 baseline 就只有 27 分,而 $r = 32$ 会再掉 18 分。
在目前这些实验里,这是唯一一个明显受到 state size 限制的任务。
而且它不是普通的 retrieval,而是 many-item aggregation。
还有一个现象比较特别。
在 64K variable tracking 上,只保留 top 12–32 个方向,分数反而提高了 8–19 个点。
backbone 和 control 都能看到这个现象,paired standard error 大约是 3–5。
这些 effective rank 几乎忽略掉的低能量 tail,并没有帮助模型保存更多信息。
至少在这个任务里,它们更像是过去写入 state、经过 decay 后留下来的残余,而这些残余会对当前计算产生 interference。
4. 我觉得这些结果说明了什么
Effective rank 更像是在反映 horizon 和 key diversity,而不是 state 里存了多少“内容”。
它可以告诉我们一个 head 能记多远,以及 key 之间有多相关,但不能直接告诉我们 state 里具体存了什么。Qwen3.5-0.8B 的 long-horizon head 虽然有 128 个可用方向,实际的能量却只集中在几十个方向上,很大程度上是因为这些 head 的 key 彼此非常相似。
Web-text perplexity 很难反映 recurrent memory 是否还在正常工作。
一个模型即使已经损失了四分之一的 long-range retrieval 能力,perplexity 可能也只变化 2%。所以如果讨论的是 state capacity,只看 PPL 很容易漏掉真正的长程记忆退化,至少还需要配合 retrieval 或 aggregation task。
大多数任务只需要 4–12 个方向,但也有例外。
绝大多数 head 的 state 都可以压得很小,而几乎看不到性能变化。不过 many-item counting 明显不同,它需要超过 32 个方向,而且恰好也是这个模型最难处理的任务之一。
低能量 tail 不一定是有用的 memory,有时反而会造成干扰。
在 variable tracking 上,删掉这些方向之后性能反而更好。这说明,比起单纯把 state 做大,减少 state 内部的 cross-talk 可能更重要,例如缩短 effective horizon,或者让 key 之间更不相关。
反过来说,那些会重新放大低能量方向的 readout,也未必一定有帮助。
最后还是要说明这些实验的范围。
这里只测了一个 0.8B 模型,而且它是 hybrid model,full-attention layer 从头到尾都没有动。所以这里观察到的始终是 full attention 存在时,linear state 所承担的作用。
Perplexity 只测了 8 个文档。Aggregation 每个设置只有 50 个样本,因此 5 分以内的差异不应该过度解读。
另外,truncation 每 256 token 才做一次,所以这里的 $r$ 只表示跨 segment 传递的 memory rank,并不能说明 head 在单个 segment 内部用了多少维。
64K common-words 的 baseline 本身已经比较低。因此,它在低 rank 下进一步下降,与 capacity bottleneck 的解释是一致的,但还不能单凭这个结果证明 state capacity 就是唯一的限制因素。